Un agent peut consommer beaucoup pour une modification de quelques lignes. Il cherche le bon fichier, lit ses dépendances, lance des tests, examine leurs sorties, puis recommence après une première correction. Le code produit ne raconte qu’une petite partie du travail facturé.
Quand la consommation augmente, passer à un modèle moins cher paraît simple. Mais face à un diagnostic difficile, un modèle moins capable multiplie les tentatives. Et un contexte trop réduit prive l’agent de l’information dont il avait besoin pour réussir.
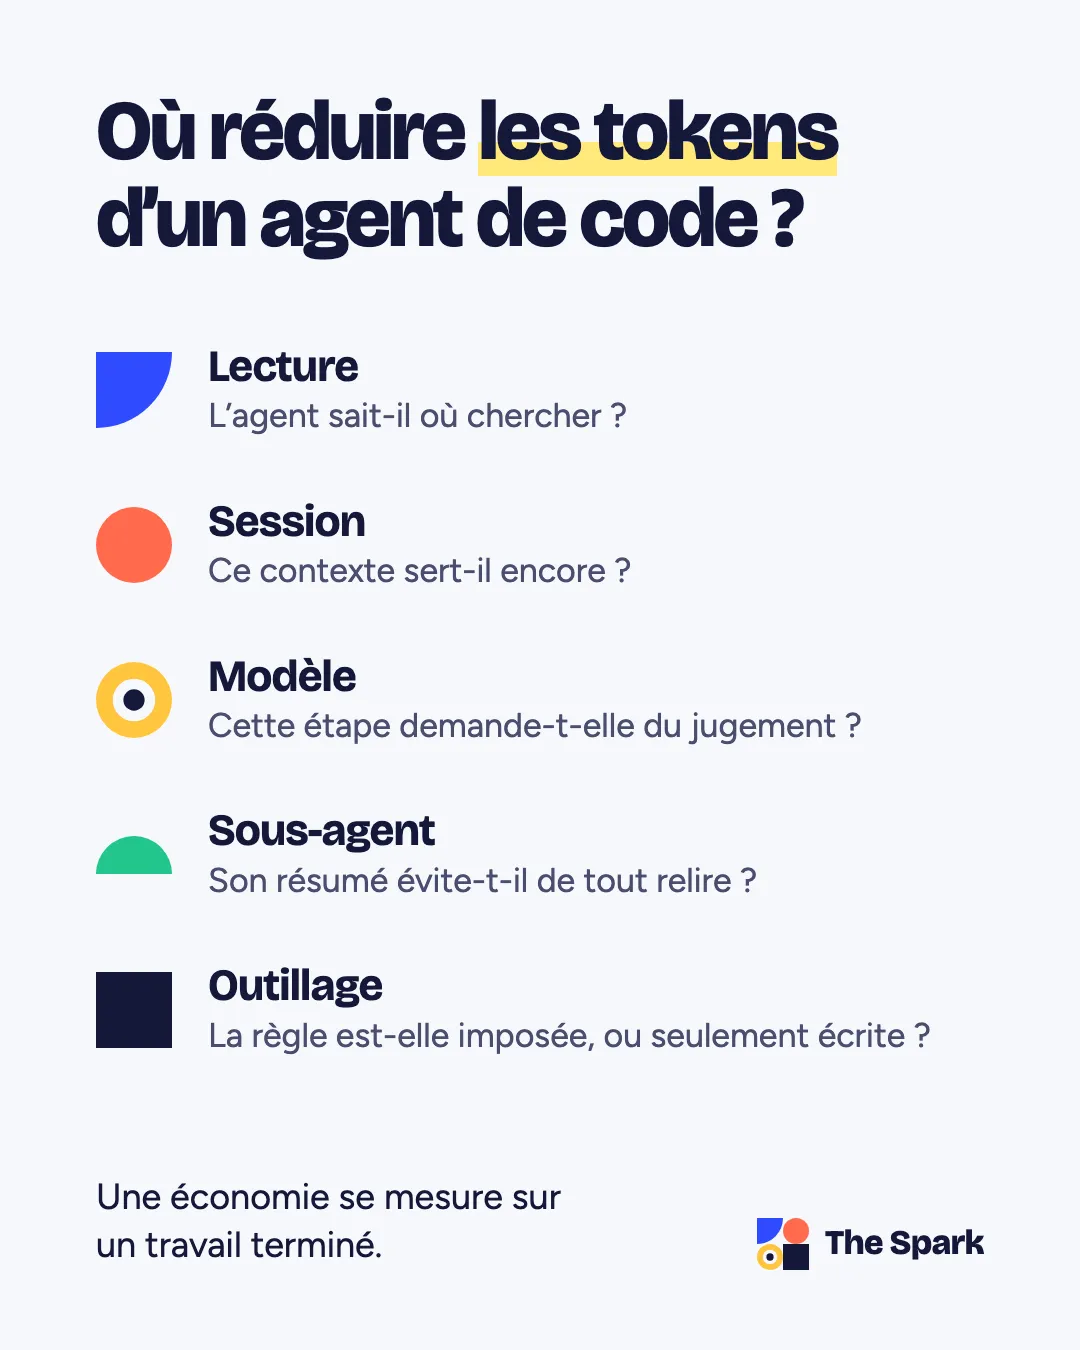
On part d’un principe : le modèle le plus capable sert aux étapes qui demandent du jugement, la lecture préparatoire et le travail répétitif peuvent passer ailleurs, et l’outillage fait respecter ce partage. Pour l’appliquer, il faut savoir ce que l’agent consomme à chaque étape et ce que cette étape apporte au résultat.
Ce qu’une session fait lire au modèle
Un token est une unité de texte traitée par le modèle, parfois un mot, parfois un fragment. Dans une session de code, le modèle lit bien plus que la demande initiale : instructions du projet, fichiers consultés, réponses précédentes et résultats des outils.
L’agent alterne des appels au modèle et des actions. Le résultat d’une recherche ou d’un test alimente la décision suivante : c’est cette boucle, décrite dans la documentation de Claude Code, qui lui permet de corriger son travail.
À chaque appel, Claude Code renvoie la conversation conservée. Un gros journal de tests continue donc de peser bien après le diagnostic qui avait motivé sa lecture.
Le levier le plus simple consiste à donner à l’agent un accès précis à l’information. Le chemin d’un fichier et le nom d’une fonction constituent un meilleur point de départ qu’une exploration sans périmètre.
Prenons un cas hypothétique : un test de connexion échoue. On commence par le message d’erreur et le test concerné, puis on élargit vers le code appelé. Si cela ne suffit pas, l’exploration continue. On évite les lectures inutiles sans empêcher l’agent de chercher les dépendances nécessaires.
Même logique pour les sorties de commandes. Une synthèse des échecs, avec un accès au journal complet, suffit souvent au premier diagnostic. Couper arbitrairement les dernières lignes risque au contraire de masquer l’erreur utile.
Le cache change le prix de la relecture
Relire n’a pas toujours le même prix. Le prompt caching réutilise le début commun des requêtes : la partie déjà vue est relue à un tarif réduit, à condition que le contenu n’ait pas changé et que le cache soit encore valide.
La page de Claude Code consacrée aux coûts en tire une conséquence concrète. Dans une session ouverte toute la journée, une question d’une ligne consomme pour toute la conversation, au tarif du cache. Après une pause plus longue que la durée de vie du cache, le premier message retraite tout le contexte au tarif normal.
Deux sessions au même volume d’entrée peuvent donc coûter des montants différents. Pour comparer, il faut distinguer les entrées nouvelles, les écritures et lectures du cache, puis les sorties du modèle.
Le bon découpage suit le travail à accomplir. Repartir de zéro après chaque action oblige à reconstruire un contexte encore utile. Garder toute une journée de sujets sans rapport alourdit chaque échange. Changer de sujet justifie une session vide : la commande /clear ne coûte rien. Résumer la conversation avec /compact garde la continuité, mais ce résumé est lui-même une grosse requête, puisque le modèle relit tout ce qu’il condense. On conserve ce qui sert à terminer le chantier, puis on transmet une synthèse utile au suivant.
Répartir le travail entre modèles
Le choix du modèle se fait à l’échelle de la sous-tâche. Extraire une liste de paramètres d’un fichier documenté et diagnostiquer un défaut intermittent ne demandent pas les mêmes capacités.
Dimitri Mazmanov, responsable produit de Portal chez Spotify, décrit son propre usage de Claude Code dans un article de Spotify Engineering. Un modèle moins cher lit les gros fichiers et renvoie un résumé ; Claude garde le raisonnement. Un hook bloque la lecture complète d’un fichier de plus de 350 lignes, seuil réglable, et renvoie vers la lecture déléguée. La lecture d’un extrait reste possible.
Sur quatre scénarios dans un dépôt Java, il rapporte environ 90 % de tokens lus en moins par Claude pour ces lectures déléguées.
Il en donne aussi les limites. Le coût du modèle lecteur reste à ajouter, et la qualité des réponses fondées sur les résumés n’est pas mesurée. Le petit modèle a manqué un bug de concurrence subtil, que Claude a trouvé une fois le bon contexte en main. Chaque délégation ajoute 10 à 30 secondes. Avant de modifier le code, Claude relit l’extrait exact, car un résumé ne donne pas de numéros de ligne fiables. Enfin, l’auteur présente un produit dont il est responsable.
On en tire une règle de travail : déléguer d’abord une tâche bornée, dont la sortie se vérifie facilement, et garder le modèle le plus capable là où une omission peut faire dérailler la suite. Résumer du code, c’est déjà choisir ce qu’on garde. La frontière entre lecture et jugement se teste donc sur les tâches réelles de l’équipe.
Un sous-agent consomme aussi
Un sous-agent explore dans son propre contexte et ne transmet qu’une synthèse : la conversation principale reste plus légère. Mais il effectue ses propres appels, qui comptent dans l’usage. Son modèle se configure séparément, comme le précise la documentation des sous-agents.
L’économie se calcule donc sur l’ensemble : ce que le sous-agent lit, le prix de son modèle, son résumé et les lectures que l’agent principal devra refaire. Une synthèse trop vague oblige souvent à refaire l’exploration.
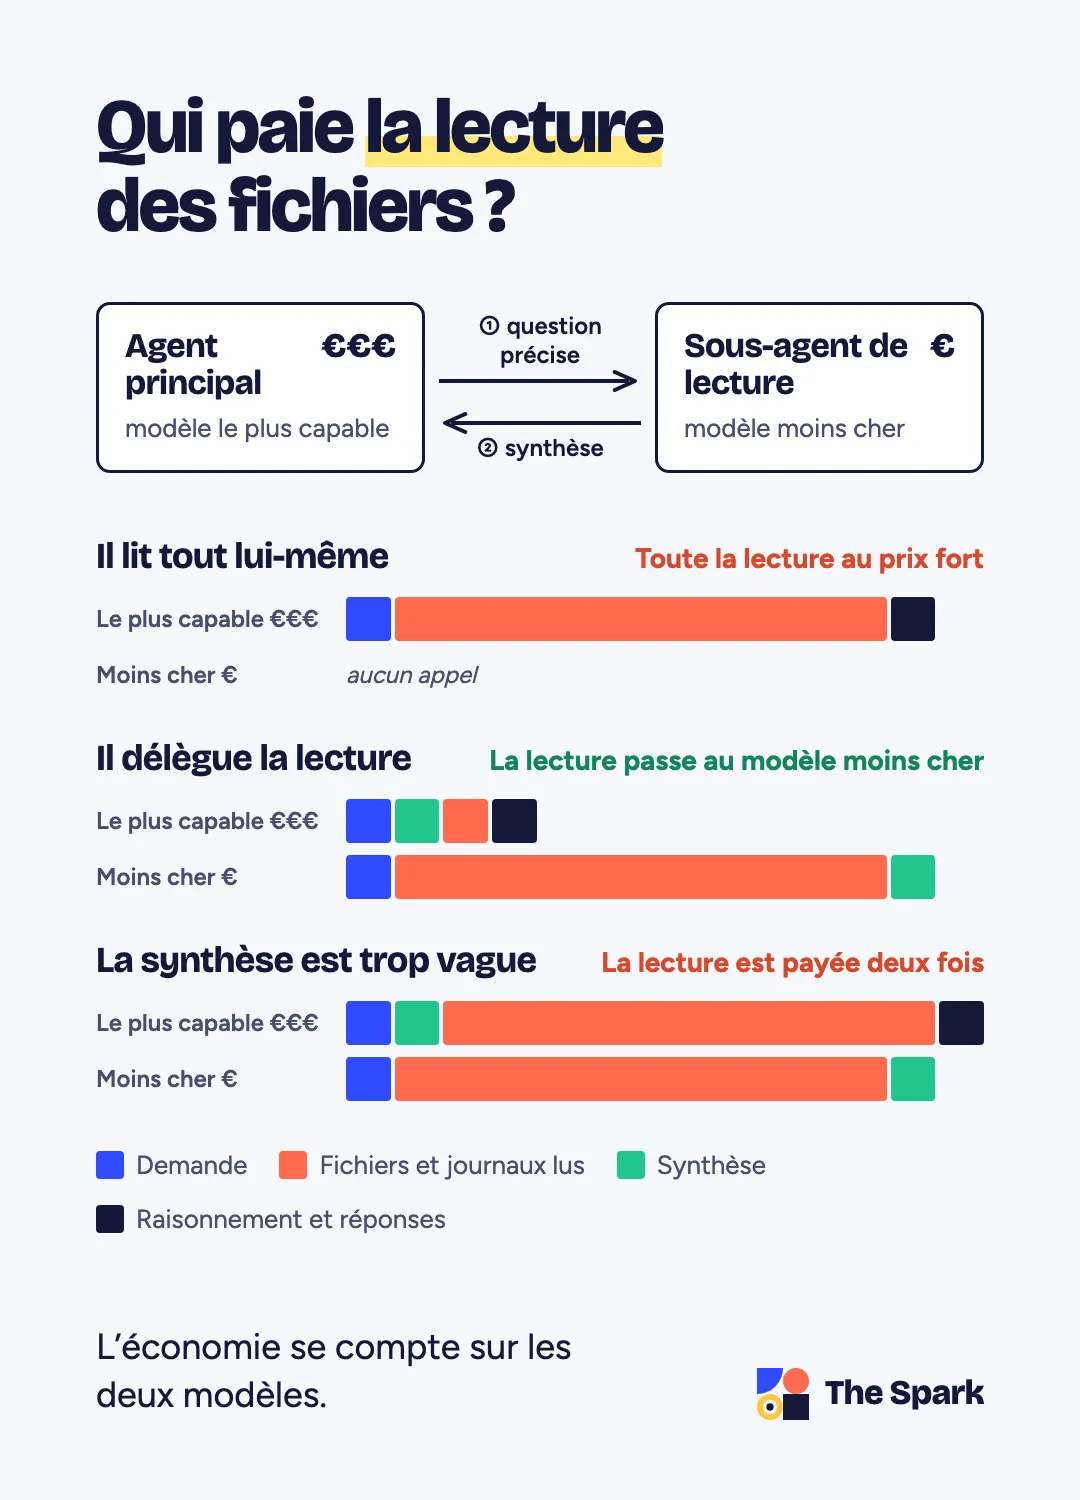
Avant de déléguer, on précise la question et la forme du retour. Par exemple : retrouver les endroits où une permission est vérifiée, avec les chemins des fichiers et les cas non couverts. L’agent principal reçoit alors des éléments qu’il peut contrôler.
Paralléliser répond à une autre attente : réduire le délai. Plusieurs agents qui cherchent en même temps accélèrent le travail et augmentent la consommation. On décide si le délai gagné justifie ce coût. L’article sur l’organisation du travail des agents détaille les conditions d’une parallélisation utile.
Faire respecter les choix dans l’outillage
Une consigne écrite dans les instructions du projet peut être ignorée. C’est pour cette raison que Mazmanov a choisi un hook : ses règles dans le fichier CLAUDE.md étaient « indicatives, pas imposées », et Claude pouvait les ignorer. Le hook, lui, s’exécute à chaque lecture, que l’agent y pense ou non.
Une politique utile précise quels fichiers lire directement, quand demander un résumé et quelles vérifications conserver. Écrire « économise les tokens » ne donne à l’agent aucune prise.
Les hooks, des scripts que l’outil exécute avant ou après certaines actions, appliquent ces contrôles. Les skills, des procédures écrites que l’agent charge quand il en a besoin, lui évitent d’explorer pour retrouver une méthode. Anthropic montre par exemple un hook qui ne laisse passer que les échecs d’une suite de tests, pour limiter ce qui entre dans le contexte.
Chaque contrôle doit laisser un chemin pour accomplir le travail. Si une lecture entière est refusée, l’agent doit pouvoir obtenir un extrait ou une synthèse. S’il lui manque une information, il doit pouvoir revenir à la source. Un blocage qui provoque des tentatives répétées annule le gain attendu.
Un seuil de taille reste un réglage de départ. Sa pertinence dépend du dépôt, des tâches et des modèles utilisés : il s’ajuste à l’usage, comme le reste de l’outillage.
Comparer sur un travail terminé
Pour commencer, on prend quelques tâches représentatives : une correction avec un test reproductible, une modification suivant un motif existant, une recherche dans un module peu connu. On garde le même point de départ et les mêmes critères de réussite pour comparer deux façons de les traiter.
Le relevé peut rester simple :
| Ce qu’on observe | Ce que cela permet de vérifier |
|---|---|
| Consommation par modèle, cache distingué | Où le budget part et où il se déplace |
| Nombre de tentatives et de reprises | Si l’économie initiale tient jusqu’au résultat |
| Vérifications réussies, défauts restants | Si le travail conserve la qualité attendue |
| Temps écoulé et intervention humaine | Si le gain en tokens impose un autre coût |
On change ensuite un seul levier : lecture ciblée, filtrage des journaux ou modèle du sous-agent. Sur les tâches importantes, on répète l’essai pour ne pas prendre une réussite isolée pour une règle fiable.
Un compteur se lit avec son périmètre. Sur nos propres sessions de juin et juillet 2026, rtk, un outil libre qui filtre les sorties de commandes avant qu’elles n’atteignent l’agent, a compté 62 millions de tokens économisés sur 16 405 commandes, soit 84 %. Mais 59 millions viennent des seules recherches dans le code, alors qu’une recherche n’est réduite que de 11 % en moyenne : les plus gros résultats font l’essentiel du total. Et le compteur compare la sortie brute à la sortie filtrée. Il ne dit ni ce que l’agent aurait réellement lu, ni si le filtre lui a fait perdre une information utile.
Le gain se lit aussi selon le contrat. Avec un abonnement, il se traduit par davantage de travail dans le quota disponible, sans baisse du montant mensuel. Avec une facturation à l’usage, il apparaît directement dans la dépense. Les compteurs d’une session et la facture n’ont donc pas toujours la même signification.
Pour démarrer, une équipe choisit un seul point : une exploration qui relit trop de fichiers, des journaux trop volumineux ou une tâche répétitive confiée au modèle le plus cher. Elle garde le réglage si le gain se retrouve sur des tâches terminées, avec les vérifications attendues, et le retire sinon. Le coût qui compte reste celui d’un résultat acceptable, reprises comprises, comme on l’a développé à propos de l’autonomie des agents IA.
Notre formation pour les équipes techniques consacre une partie à ces réglages, travaillés à partir des situations que l’équipe rencontre.